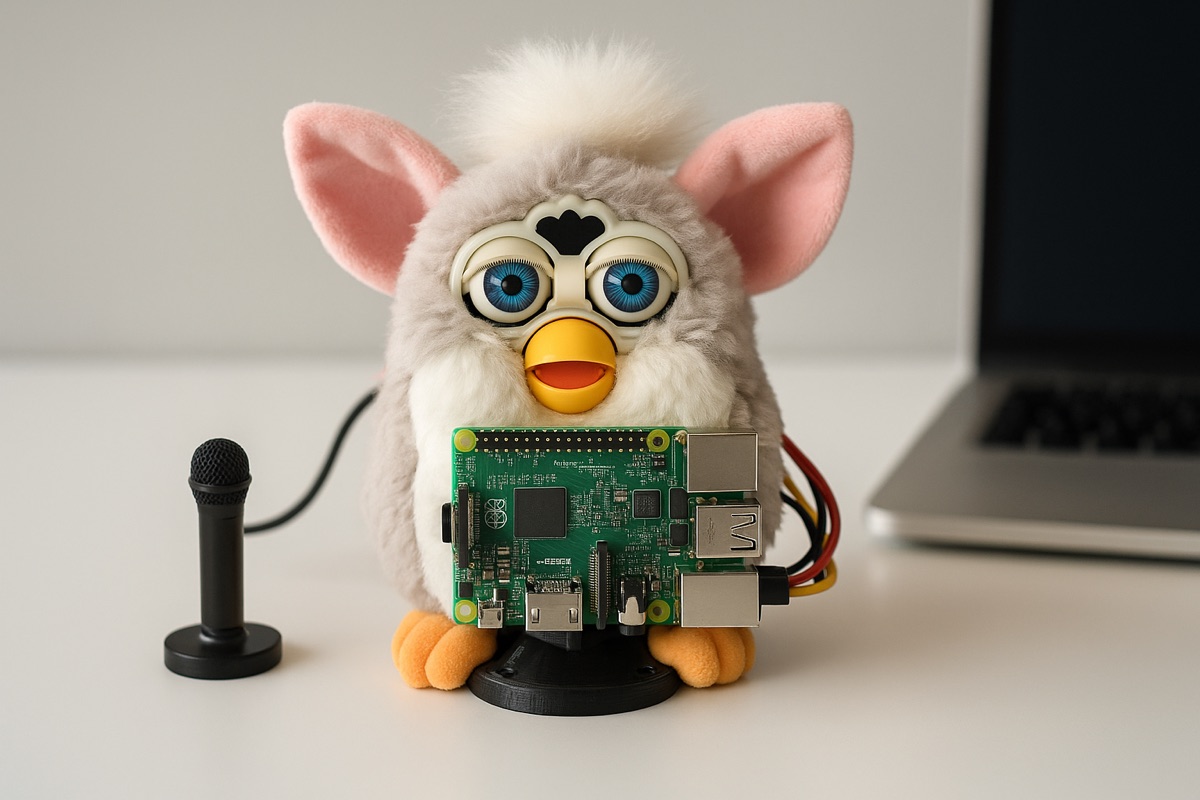
¿Qué es?
Un Furby de 1998 convertido en asistente de escritorio con IA. Por fuera sigue siendo el mismo peluche de los 90; por dentro lleva una Raspberry Pi W, un HAT de audio y un driver de motor. Le dices la palabra de activación, le hablas con normalidad y te responde con voz sintetizada mientras se mueve como hacía el original.
¿Por qué lo hice?
Pura nostalgia con excusa técnica. Quería ver si era posible meter un pipeline completo de voz (wake word, transcripción, LLM y síntesis de voz) en un juguete de hace más de 25 años sin que pareciera un ordenador disfrazado. Fue mi primer proyecto serio con asistentes por voz y la base sobre la que después construí K-VRC.
Cómo funciona
Hardware
- Furby de la generación 1998–2000
- Raspberry Pi W con sus accesorios
- WM8960 Audio HAT para micrófono y salida de audio
- Puente H L298N para controlar el motor original del Furby
- Altavoz externo (el original funciona, pero suena bastante mal)
Software
El flujo de una interacción es:
- Activación: Porcupine (Picovoice) escucha en local la palabra clave, sin enviar audio a ningún sitio hasta que la detecta.
- Escucha: se graba lo que dices y se transcribe con Whisper o con Google Speech-to-Text.
- Respuesta: el texto va a OpenAI, que genera la contestación.
- Voz: la respuesta se sintetiza con Google Cloud Text-to-Speech (con ElevenLabs como opción).
- Animación: mientras reproduce el audio, la Pi mueve el motor a través del L298N para que el Furby "hable".
Para arrancarlo solo hace falta configurar las claves de OpenAI, Google Cloud y Picovoice e instalar las dependencias de Python.
Stack
| Capa | Tecnología |
|---|---|
| Lenguaje | Python |
| Wake word | Picovoice Porcupine |
| STT | OpenAI Whisper / Google Speech-to-Text |
| LLM | OpenAI |
| TTS | Google Cloud Text-to-Speech (ElevenLabs opcional) |
| Audio | WM8960 Audio HAT |
| Motor | Puente H L298N |
| Licencia | MIT |
Estado
Terminado y en pausa. Funciona tal y como se ve en el vídeo, y lo que aprendí aquí lo llevé a K-VRC, que es donde sigo iterando. Si lo retomo, lo primero sería recortar la latencia entre pregunta y respuesta y darle una voz más "Furby".
Enlaces
- Repositorio: https://github.com/Guilleloma/Furby-GPT
- Vídeo demo: https://www.youtube.com/watch?v=fOhkSsQ2j3M